Ligne directe INNN, bonjour ! Posez-moi votre question sur le salon
Un téléphone à cadran des années 60, une IA qui tient dans un ordinateur portable, et deux jours de salon à Niort.
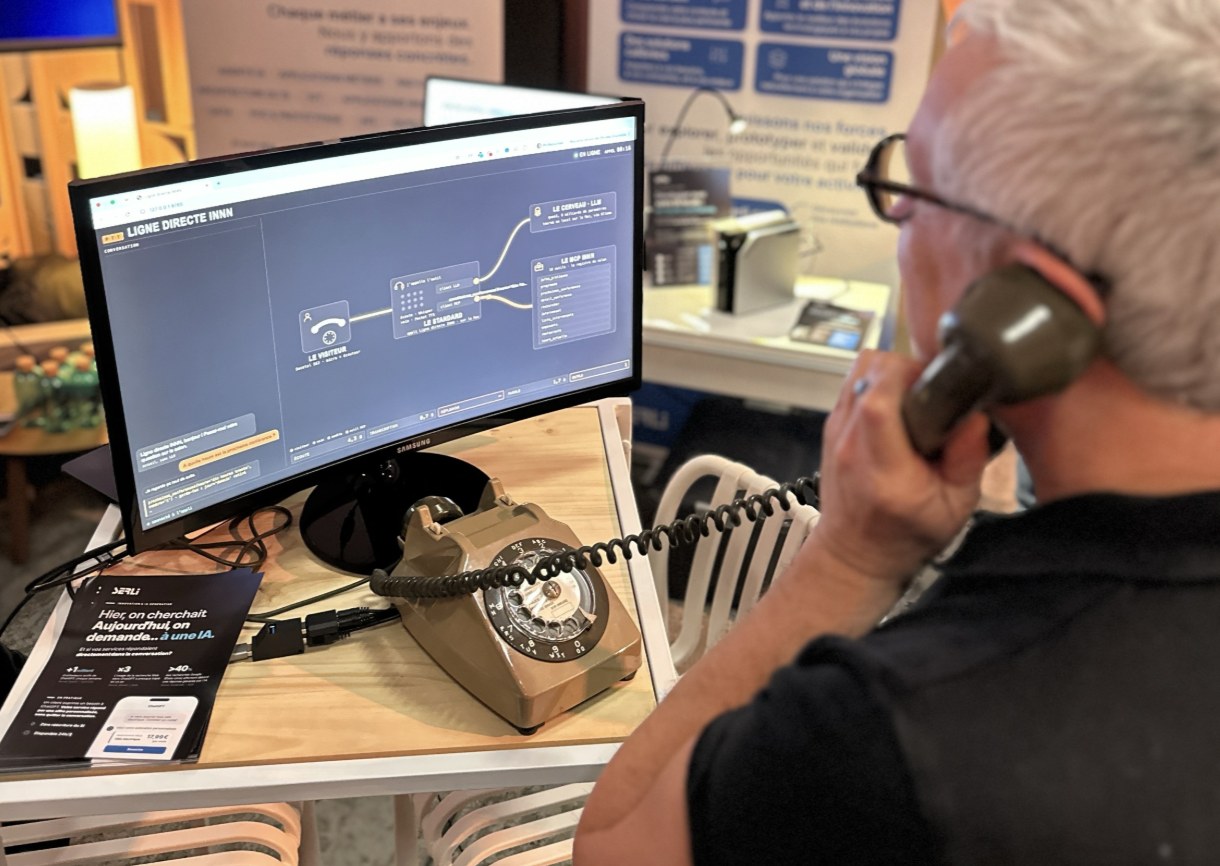
Sur le stand de SERLI au salon INNN, il y avait un téléphone à cadran des années 60. On décroche, on pose sa question à voix haute, et une voix répond dans le combiné.
On pouvait lui demander ce qu’il y a à quatorze heures, où se trouve un exposant, qui est tel intervenant, ou même où manger ce midi.
Au bout du fil, pas de standardiste : une IA qui connaît le programme du salon et qui tourne entièrement en local, sur un ordinateur portable.
L’idée
INNN, c’est le salon de l’innovation numérique, de l’insurtech et du risque, qui se tenait à Niort les 4 et 5 novembre. Mathieu Ancelin et moi travaillons chez SERLI, qui avait un stand sur le salon. Nous cherchions une démo qui donne envie de s’arrêter. Sur un salon d’innovation, tout le monde montre des écrans. Nous avons voulu faire l’inverse.
L’idée tient en une phrase : un objet que tout le monde connaît, pour une technologie que tout le monde découvre. Personne n’a besoin d’un mode d’emploi pour se servir d’un téléphone. On décroche, on parle, on écoute. C’est l’interface vocale la plus naturelle qui soit, et elle a plus de soixante ans.
Nous avons aussi voulu que tout tourne en local. Le wifi d’un salon est rarement fiable, et c’était l’occasion de vérifier une intuition : aujourd’hui, un portable suffit pour faire tourner un assistant vocal complet, sans cloud.
Redonner vie à un Socotel S63
Notre téléphone est un Socotel S63, le modèle des PTT que beaucoup ont connu chez leurs grands-parents. Nous l’avons trouvé sur leboncoin, à Poitiers, pour 20 euros.
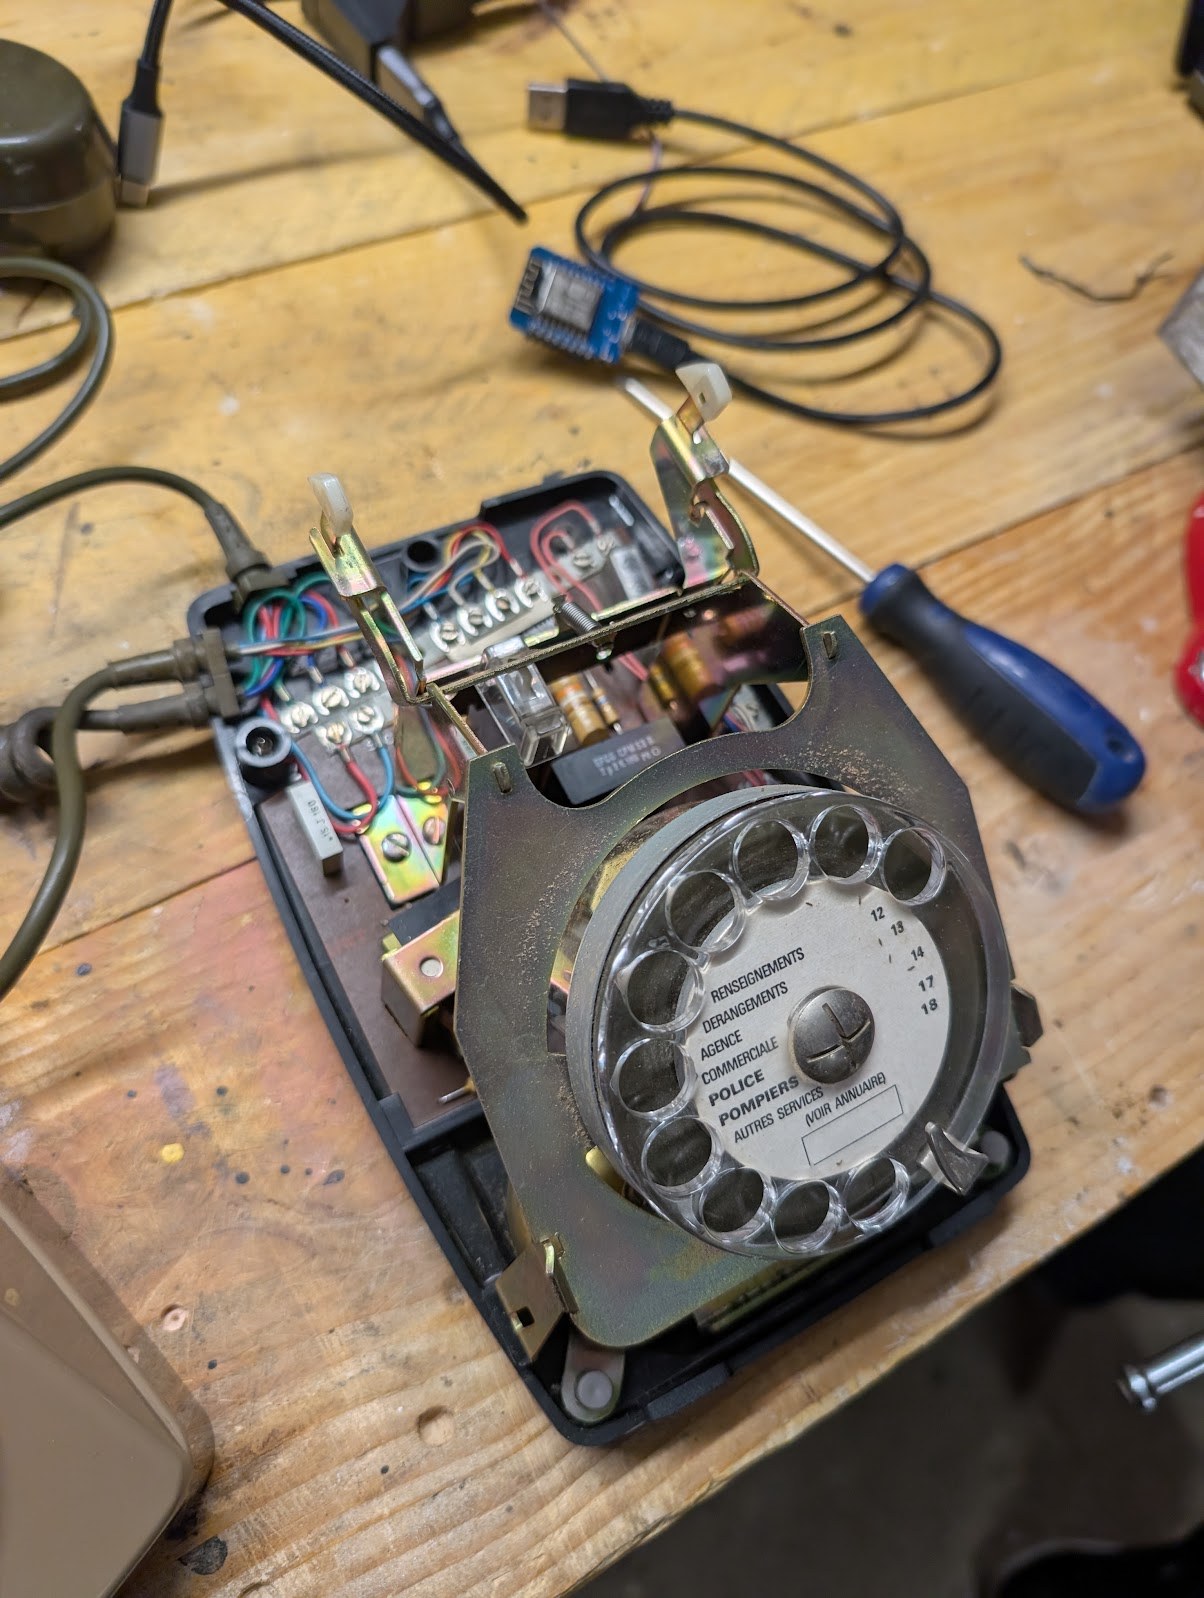
Une règle dès le départ : ne rien abîmer. Le combiné et son cordon sont restés d’origine, et tout se passe dans le socle. Le micro et l’écouteur du combiné sont reliés à une petite carte son USB.
Une carte microcontrôleur de quelques euros, un Wemos D1 mini, surveille le crochet sur lequel repose le combiné. Elle prévient l’ordinateur quand on décroche ou quand on raccroche. Un mini hub USB regroupe le tout, et un seul câble sort du téléphone.
Côté micro et écouteur, le câblage a été assez simple : deux fils chacun, jusqu’aux prises de la carte son. Le multimètre a surtout servi pour le crochet, pour trouver quelles lames de contact basculent quand on décroche et quand on raccroche.
Ce qui se passe quand on décroche
Au centre, il y a notre application. Comme un standard, c’est elle qui fait passer la question d’une brique à l’autre.
- L’oreille. Quand le visiteur a fini de parler (il suffit de se taire un peu moins d’une seconde), sa question est transcrite en texte par Whisper, le modèle de reconnaissance vocale d’OpenAI, qui tourne directement sur la puce du Mac.
- Le cerveau. L’application envoie ce texte à un modèle de langage : Qwen3, un modèle ouvert d’Alibaba, dans sa version à 8 milliards de paramètres, servi en local par Ollama.
- Le programme du salon. Le modèle ne connaît rien du salon. Quand il a besoin d’une information, il demande à l’application d’interroger un serveur qui connaît tout le programme : 46 sessions, 104 intervenants, 86 exposants, les infos pratiques et même une sélection de restaurants du coin. Ces données viennent du site du salon.
- La voix. La réponse est lue par Pocket TTS, un petit modèle de synthèse vocale conçu par Kyutai, un laboratoire français, avec la voix « Estelle ».
Le cerveau ne parle jamais directement au programme. Quand il a besoin d’une information, il demande à l’application d’appeler un outil, et l’application lui rapporte le résultat.
Pour les développeurs : le serveur du programme parle MCP (Model Context Protocol), le protocole ouvert qui permet de donner des outils à un modèle de langage. Il ne sait rien du téléphone. On pourrait le brancher sur n’importe quel assistant compatible, ou changer de modèle sans toucher aux données.
Le téléphone, lui, ne fait que relayer. Le tout tourne sur un MacBook Pro M3 Pro.
Ce que nous avons appris en chemin
Au téléphone, le silence est l’ennemi
Devant un écran, on attend une réponse sans même s’en rendre compte. Au téléphone, trois secondes de silence, c’est long : on se demande si ça a coupé.
Or Qwen3 est un modèle qui « réfléchit » : avant de répondre, il rédige pour lui-même un raisonnement que personne ne lit. Lors de nos premiers essais, une simple question pouvait prendre 90 secondes. Une fois cette réflexion coupée, la même réponse arrivait en 1,5 seconde.
Ensuite, nous avons fait parler le téléphone au fil de l’eau : la voix démarre dès que la première phrase est écrite, pendant que le modèle rédige la suite. Résultat : la première phrase arrive en 1,3 seconde environ, et en 3 secondes quand il faut consulter le programme.
Pour ces quelques secondes, nous avons fait comme les standardistes : on meuble. « Ne quittez pas, je cherche. » « Je consulte le grand registre du salon. » Ces phrases sont tirées au sort et ne passent pas par l’IA. De même, quand le visiteur dit « merci, au revoir », le téléphone répond tout de suite et raccroche, sans rien demander au modèle.
Parler n’est pas écrire
Au premier vrai test, nous avons demandé le programme de la journée. Le modèle a répondu comme il l’aurait fait dans une fenêtre de chat : une liste de dix lignes, lue d’une traite, sans respirer. À l’écran, c’est clair. À l’oreille, c’est incompréhensible.
Il a fallu apprendre à l’IA à parler. Le serveur du programme prépare désormais un résumé pensé pour l’oral, avec une consigne : citer deux ou trois temps forts, puis proposer le détail. Et la voix marque une courte pause entre chaque phrase.
La prononciation a demandé, elle aussi, un peu de travail. Le nom même du salon, INNN, se lisait comme une suite de lettres. Un petit lexique le transforme en « Inn », fait dire « C zéro quatre » pour le stand C04, et les heures sont écrites en toutes lettres avant la lecture : « 14h30 » devient « quatorze heures et demie ».
Le problème existe aussi dans l’autre sens. Pour aider Whisper, nous lui avions soufflé le nom du salon. Résultat : il lui arrivait de transcrire « INNN INNN INNN » en boucle. Désormais, on lui souffle « Inn ».
Un petit modèle, ça invente
Qwen3 est impressionnant pour sa taille, mais il aime combler les blancs. Un mercredi, on lui demande « Ce soir, il y a quoi ? » : le modèle va chercher le programme du jeudi. On lui demande la prochaine conférence : il ajoute de lui-même « demain matin », recopié depuis l’exemple que nous avions mis dans la description de l’outil.
Une description d’outil, c’est aussi un prompt. Et quand on cherche les intervenants de DARVA, une recherche un peu trop tolérante répond… Arthur Carvalho.
La solution : ne pas tout attendre du modèle. Le code autour de lui vérifie ce qu’il demande. S’il ajoute un jour ou une heure que le visiteur n’a jamais prononcés, on les retire, et la recherche essaie les noms exacts avant de tenter des approximations.
Plusieurs de ces corrections ont été faites sur le stand, le premier jour, entre deux appels.
Les clins d’œil rétro
Puisque l’objet est rétro, nous avons voulu que l’expérience le soit aussi, jusque dans les détails.
Au décroché, on entend d’abord la tonalité, le temps de porter le combiné à l’oreille. Pendant les recherches, l’IA fait patienter comme une standardiste d’autrefois.
Reste un problème : un téléphone, ça ne se voit pas fonctionner. Nous avons donc ajouté un écran à côté, qui montre en direct ce qui se passe pendant l’appel.
On y voit le visiteur et un standard à cordons sur lesquels circulent les messages. Le modèle de langage est dessiné comme une lampe de vieille radio, et le serveur du programme comme une boîte à outils dont le bon tiroir s’ouvre à chaque recherche.
À gauche, la conversation s’affiche en bulles, avec la phrase en cours de lecture surlignée. En bas, des compteurs donnent les temps de réponse. Les icônes sont dessinées au trait couleur cuivre : les emoji n’étaient pas assez rétro. Quand personne n’appelle, l’écran rejoue une démo en boucle.
Le jour J
Objectif atteint. Le téléphone attirait l’œil de loin, les visiteurs se sont prêtés au jeu, et ça a globalement bien fonctionné.
Les retours revenaient presque tous à la même chose : ce paradoxe entre modernité et nostalgie. Un téléphone des années 60 pour parler à une IA, ça fait sourire, puis ça fait réfléchir.
Plusieurs visiteurs ont aussi demandé l’heure, et sont tombés sur notre easter egg. À cette question, le téléphone ne passe pas par l’IA : il répond comme l’horloge parlante. « Au quatrième top, il sera exactement quatorze heures, douze minutes et trente secondes. »
Suivent quatre bips, le dernier pile à l’heure annoncée. L’horloge parlante, débranchée en 2022, a repris du service le temps d’un salon, et l’effet madeleine de Proust a bien fonctionné.
Et quand quelque chose se passe mal pendant un appel, le téléphone ne raccroche pas au nez du visiteur. Il s’excuse : « Pardon, j’ai eu un petit souci technique. Pouvez-vous reposer votre question ? » Nous avons appris à le faire le jour où une erreur dans la conversion des heures a coupé un appel de test.
Pour finir
Ligne directe INNN, c’était d’abord pour nous amuser et proposer quelque chose d’original sur le salon. Ce n’est pas un produit, c’est une démo de stand.
Au quotidien, chez SERLI, nous faisons de vraies applications et de vrais serveurs MCP, comme celui qui sert à l’application MAIF sur ChatGPT. Ce téléphone était une façon originale de montrer ce savoir-faire sur un salon : un modèle de langage, un serveur MCP et une application qui les fait travailler ensemble, cachés dans un objet que tout le monde a envie de décrocher.